هوش مصنوعی سازمانی چیست؟ راهنمای مدیران صنعتی برای شروع درست
هوش مصنوعی سازمانی یعنی به کار گرفتن هوش مصنوعی روی دادههای خود سازمان برای تصمیمهای فروش، تولید، تأمین و مالی. در این راهنما میخوانید چه پیشنیازی دارد، از کجا شروع کنید و چه اشتباههایی نکنید.

فهرست مطالب
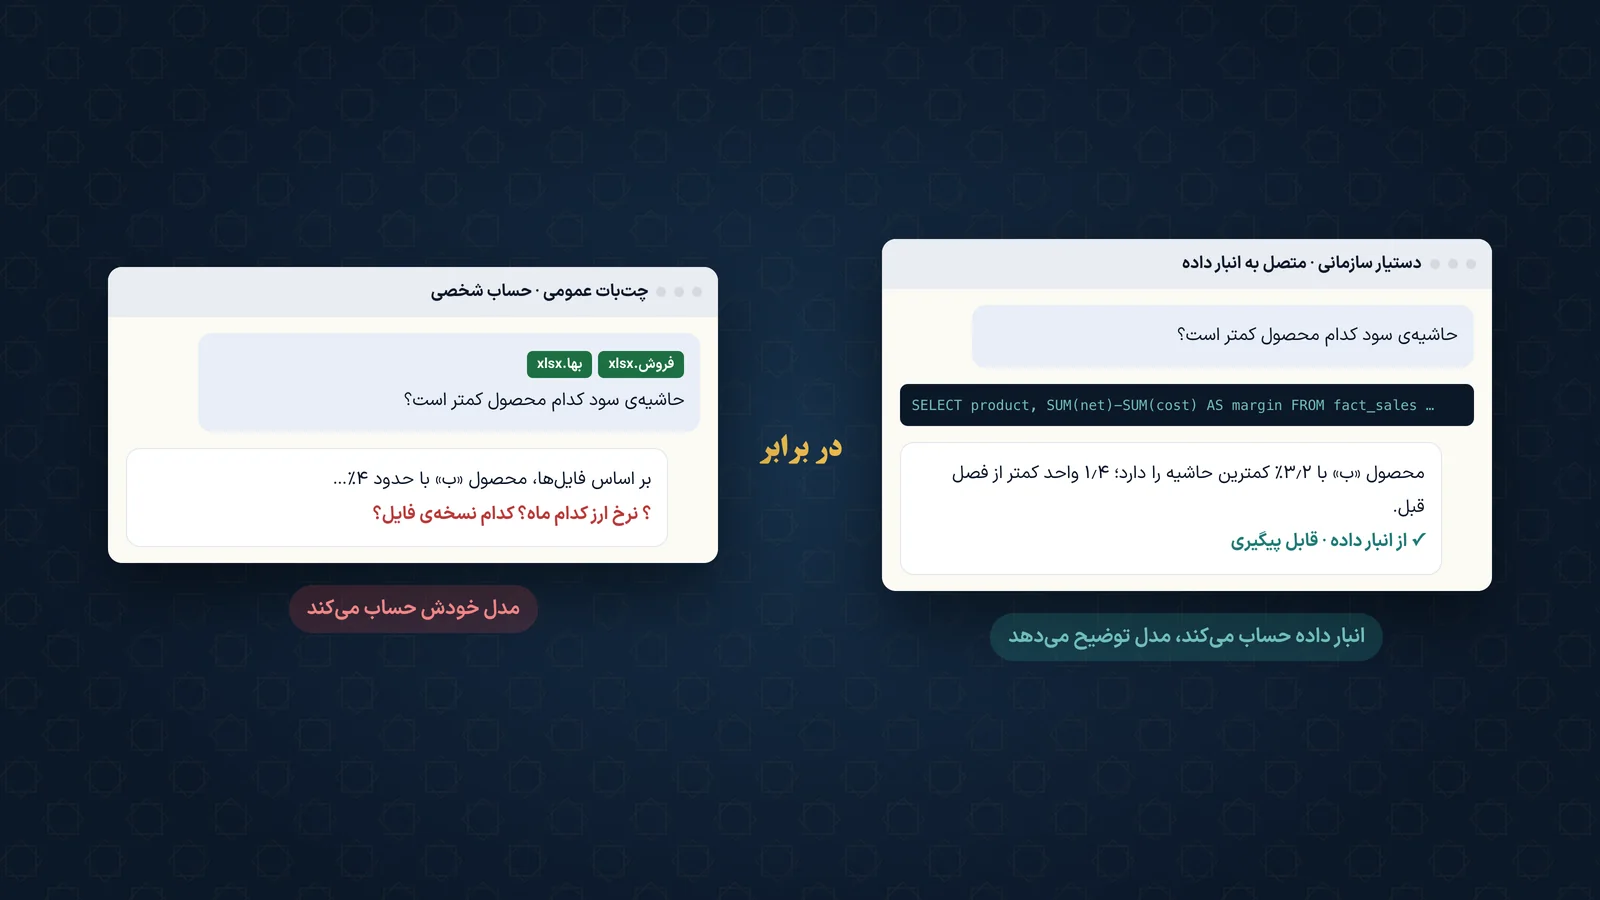
هوش مصنوعی سازمانی (Enterprise AI) یعنی به کار گرفتن هوش مصنوعی روی دادههای خود سازمان، برای اینکه مدیران سریعتر و دقیقتر تصمیم بگیرند. فرقش با یک چتبات عمومی ساده است: چتبات عمومی دنیا را میشناسد، ولی فروش شهریور شما، توقفات خط تولید یا مطالبات معوق را نمیشناسد. هوش مصنوعی سازمانی دقیقاً همینها را میشناسد.
این راهنما برای مدیرعاملها، مدیران مالی، تولید و فروش در صنایع ایران نوشته شده است: کسانی که دربارهٔ هوش مصنوعی زیاد شنیدهاند و حالا میخواهند بدانند در سازمان خودشان از کجا باید شروع کنند.
هوش مصنوعی سازمانی دقیقاً یعنی چه؟
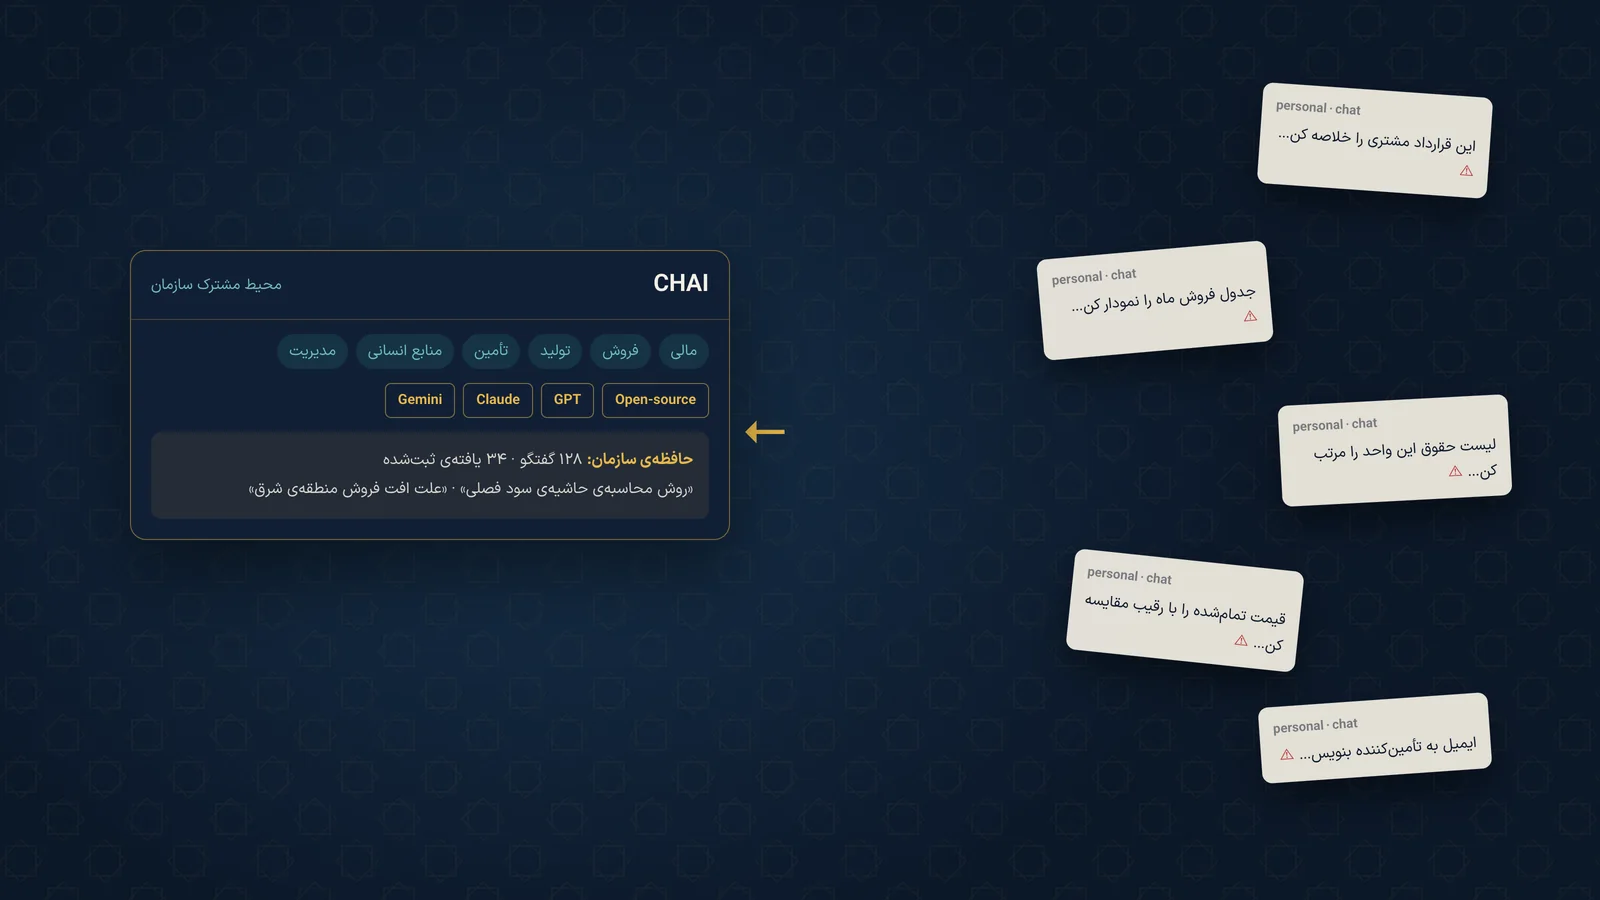
بیشتر مدیران اولین تجربهشان از هوش مصنوعی را با ابزارهایی مثل ChatGPT داشتهاند. این ابزارها در نوشتن متن، خلاصه کردن و ایده دادن خوباند، اما سه محدودیت جدی برای کار سازمانی دارند:
- دادهٔ سازمان را نمیبینند. نمیدانند حاشیهٔ سود هر محصول شما چقدر است.
- عدد میسازند. اگر داده نداشته باشند، ممکن است پاسخی باورپذیر ولی نادرست بدهند.
- سطح دسترسی نمیشناسند. نمیدانند مدیر فروش نباید حقوق کارکنان را ببیند.
هوش مصنوعی سازمانی این سه مشکل را حل میکند. به دادههای سازمان وصل است، پاسخ را از پرسوجوی واقعی روی همان داده میسازد و دسترسی هر نفر را رعایت میکند. نتیجهاش ابزاری است که میشود در جلسهٔ هیئتمدیره به عددش استناد کرد.
چرا همین حالا برای صنایع ایران مهم است؟
در اقتصادی که نرخ ارز و تورم مدام تکان میخورد، فاصلهٔ «اتفاق» تا «تصمیم» گران تمام میشود. گزارشی که آخر ماه از جمع کردن چند اکسل به دست مدیر میرسد، معمولاً دیر رسیده است. شعار صفحهٔ اول ما هم همین است: وقتی گزارش میرسد، فرصت از دست رفته است.
سه تغییر هوش مصنوعی را برای سازمانهای صنعتی ایران عملی کرده است:
- مدلهای زبانی فارسی را خوب میفهمند. مدیر میتواند سؤالش را همانطور که در جلسه میپرسد، بنویسد.
- هزینهٔ زیرساخت پایین آمده است. بخشی از کار را میشود روی سرور خود سازمان و حتی با مدلهای محلی انجام داد.
- دادهٔ کافی وجود دارد. بیشتر شرکتهای صنعتی سالهاست ERP دارند؛ مشکل کمبود داده نیست، پراکندگی آن است.
چهار لایهی هوش مصنوعی سازمانی
هوش مصنوعی سازمانی یک نرمافزار تک نیست؛ چهار لایه است که هر کدام روی لایهٔ زیرین ساخته میشود. اگر لایهٔ پایین سست باشد، لایهٔ بالا هم قابل اتکا نیست.
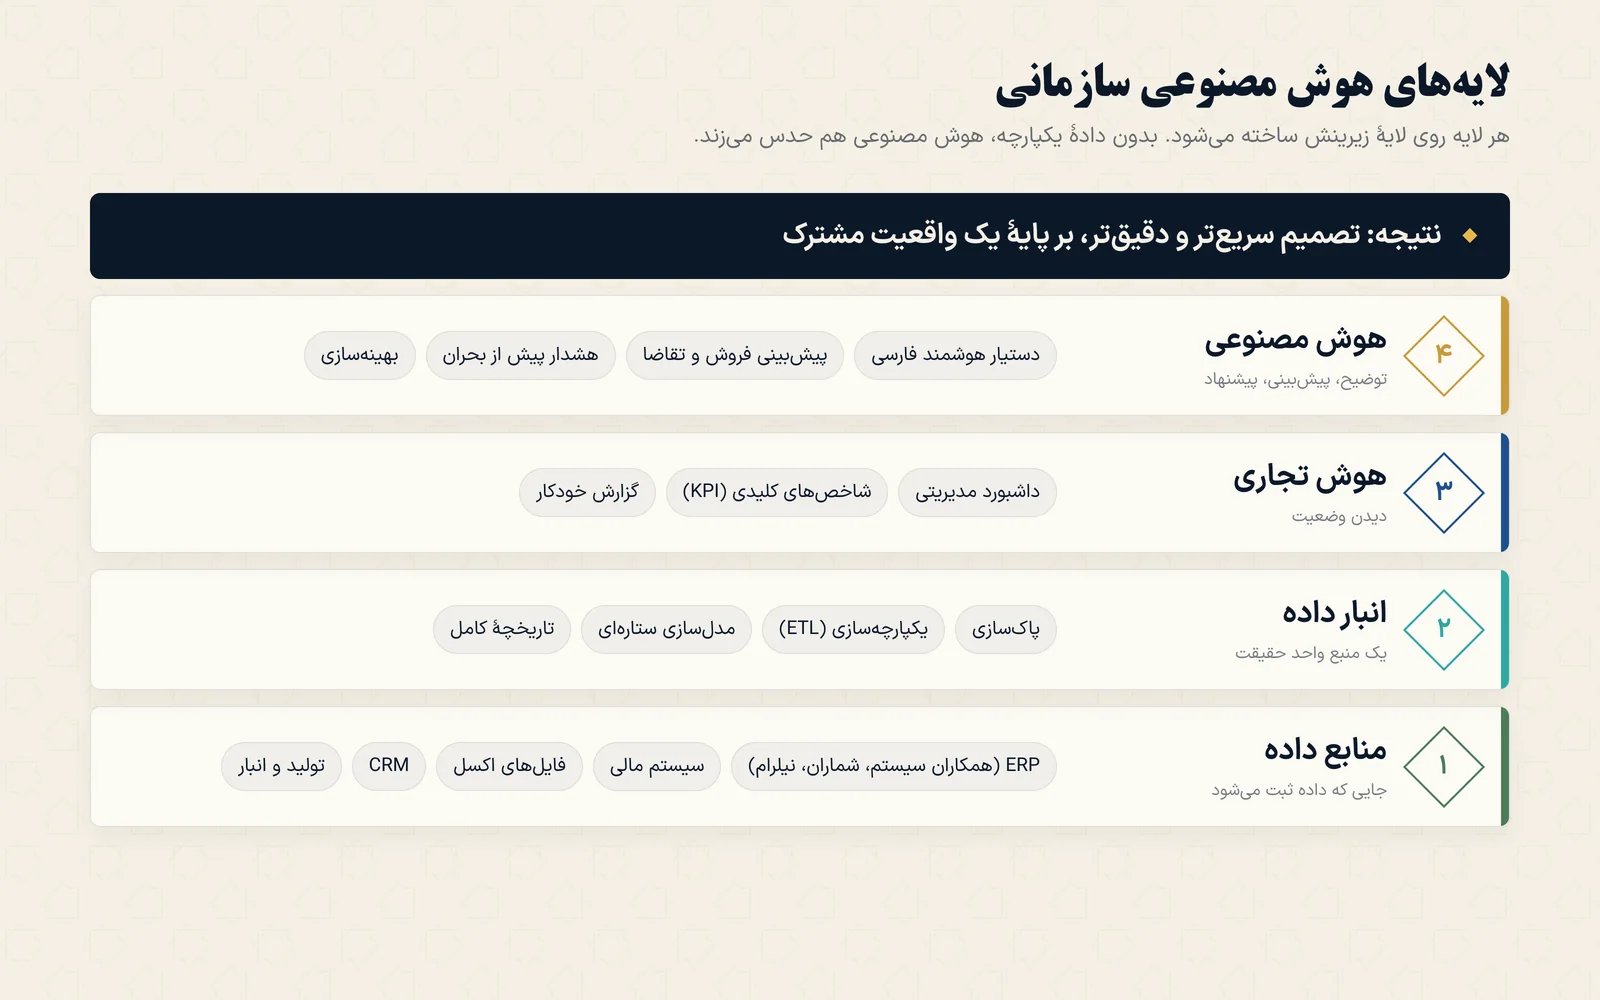
- منابع داده: ERPهایی مثل همکاران سیستم، شماران و نیلرام، سیستم مالی، CRM، دادههای تولید و انبار و البته اکسلهای واحدها.
- انبار داده: جایی که همهٔ این دادهها پاکسازی، یکپارچه و به یک مدل واحد تبدیل میشوند. دربارهٔ این لایه در مقالهٔ انبار داده چیست مفصل نوشتهایم.
- هوش تجاری (BI): داشبوردها و گزارشهایی که وضعیت را نشان میدهند. نمونهٔ کامل آن را در مقالهٔ داشبورد هوش تجاری چهارگاه ببینید.
- هوش مصنوعی: دستیار هوشمندی که توضیح میدهد، مدلهایی که پیشبینی میکنند و هشدارهایی که پیش از بحران خبر میدهند.
کاربردهای واقعی در یک سازمان صنعتی
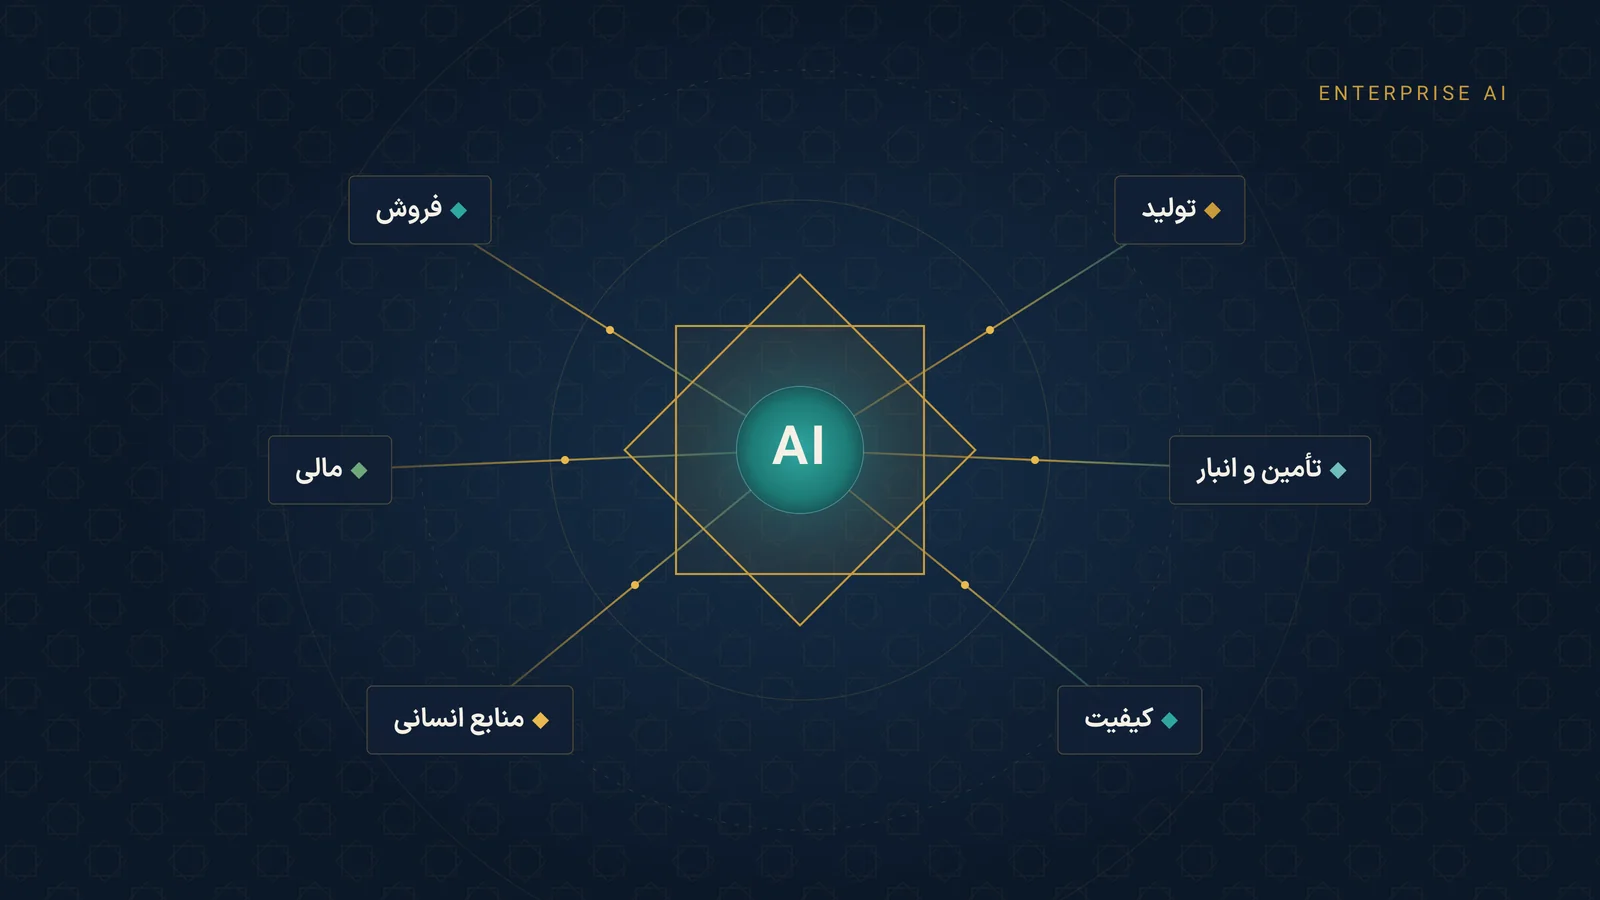
هوش مصنوعی سازمانی وقتی ارزش دارد که به یک تصمیم مشخص وصل باشد. چند نمونه از سؤالهایی که در صنایع ایران هر هفته پرسیده میشود:
| حوزه | سؤال واقعی مدیر | هوش مصنوعی چه میکند |
|---|---|---|
| فروش | کدام محصول و کدام مشتری واقعاً سودآورند؟ | فروش، تخفیف، برگشتی و بهای تمامشده را کنار هم میگذارد |
| تولید | چرا تولید ماه گذشته کمتر از برنامه بود؟ | برنامه، تولید واقعی، توقفات و کمبود مواد را مقایسه و علت را رتبهبندی میکند |
| تأمین و انبار | موجودی کدام ماده تا کی کفایت میکند؟ | مصرف آینده را از برنامهٔ تولید درمیآورد و سفارش لازم را پیشنهاد میدهد |
| مالی | بهای تمامشده با نرخ ارز امروز چقدر است؟ | بهای هر محصول را با قیمت روز مواد و هزینهها دوباره حساب میکند |
| منابع انسانی | اضافهکار کدام واحد غیرعادی بالا رفته است؟ | روند ماهانه را میخواند و انحراف را نشان میدهد |
برای همین است که در صفحهٔ زنجیرهٔ ارزش خدمات را بهجای «فناوری» بر اساس حلقههای کسبوکار چیدهایم: برنامهریزی، تأمین، تولید، توزیع و فروش.
یک تجربهی ملموس: پرسیدن از داده به زبان فارسی
شاید ملموسترین شکل هوش مصنوعی سازمانی برای مدیر، دستیار هوشمند باشد: صفحهای ساده که مدیر سؤالش را تایپ میکند و جواب را با عدد، جدول و نمودار میگیرد.
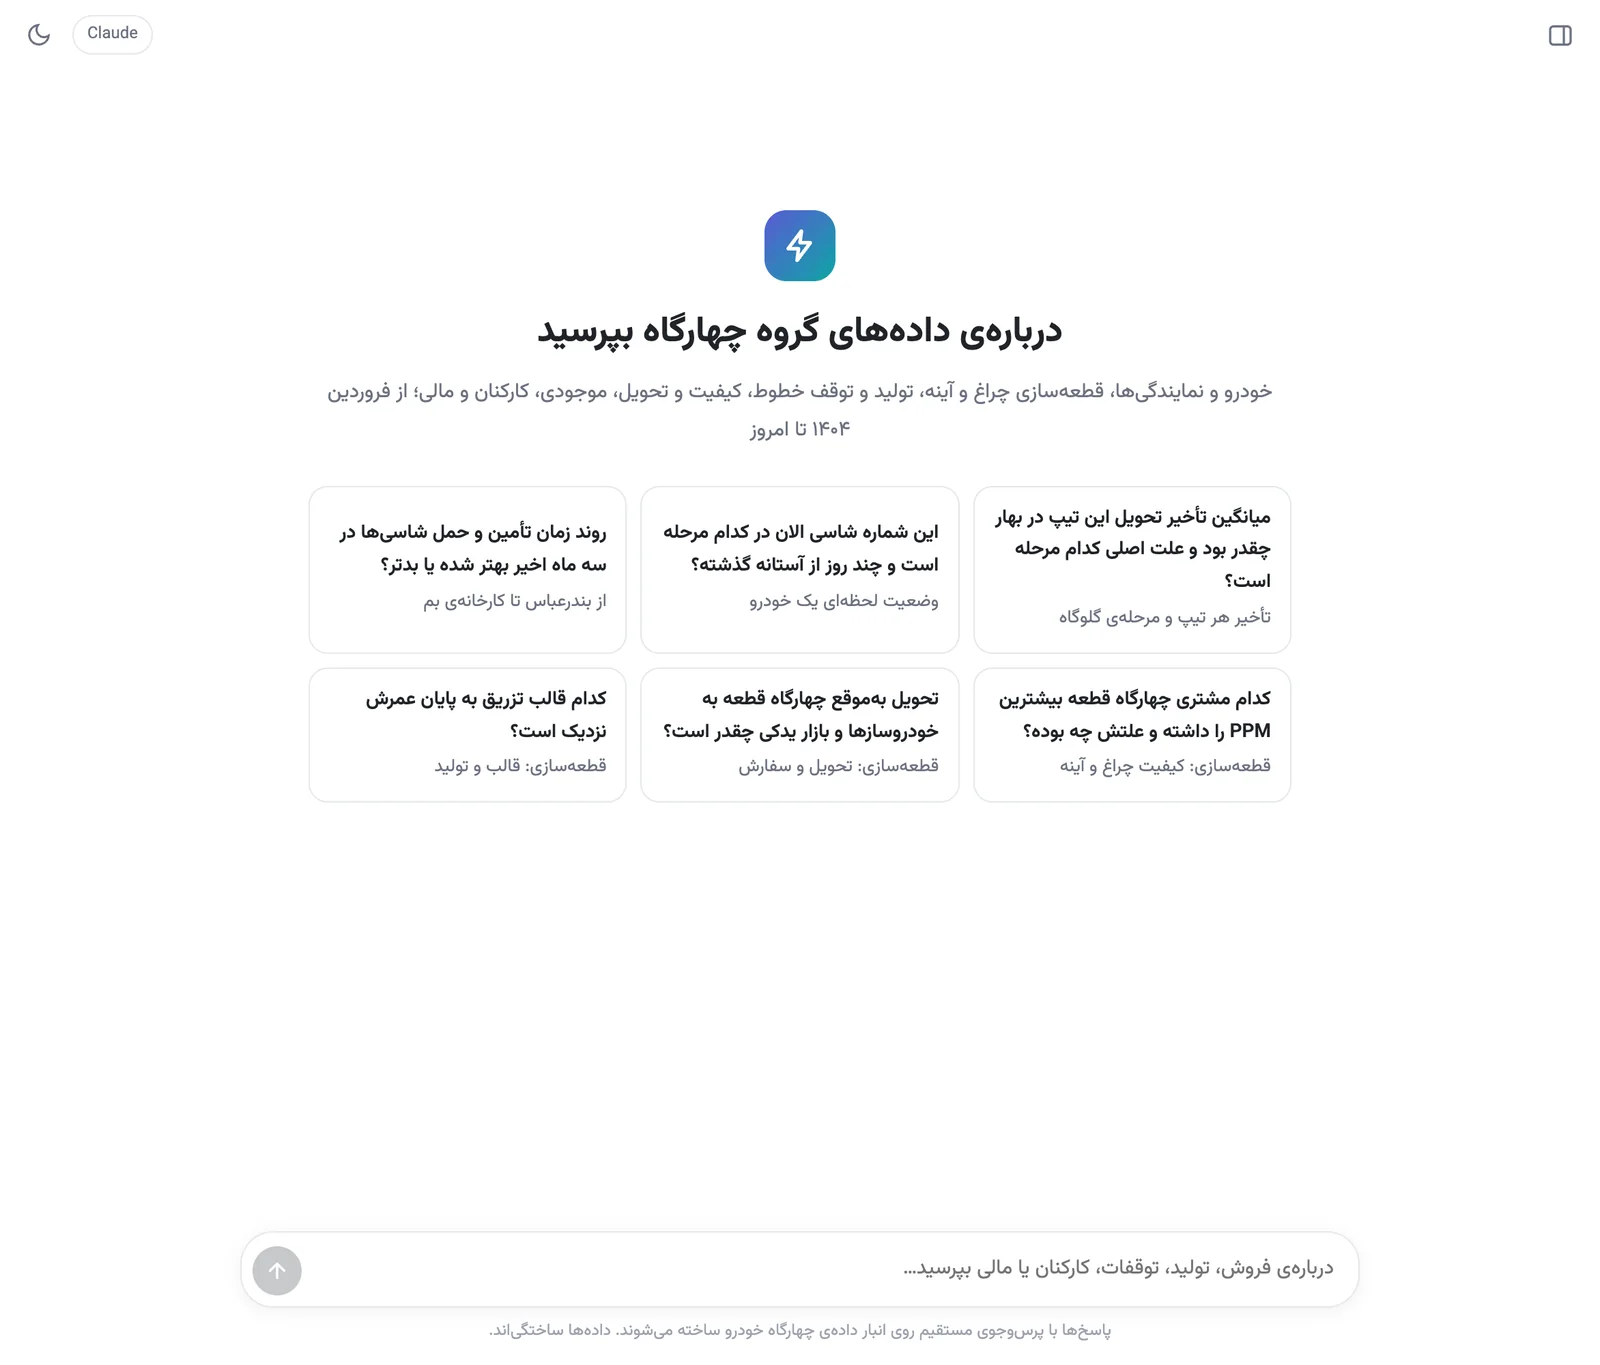
پشت این صفحهٔ ساده، همان چهار لایه کار میکنند. دستیار سؤال را میفهمد، روی انبار داده پرسوجوی فقطخواندنی میزند، نتیجه را با دورهٔ قبل مقایسه میکند و پاسخ را با مراحل تحلیل نشان میدهد. جزئیات این فرایند را در مقالهٔ دستیار هوشمند سازمانی نوشتهایم.
از کجا شروع کنیم؟ نقشهی راه سهمرحلهای
پروژههای هوش مصنوعی که با عنوان «تحول دیجیتال کل سازمان» شروع میشوند، معمولاً در جلسهها گم میشوند. ما این مسیر سهمرحلهای را پیشنهاد میکنیم:
مرحلهٔ اول: یک درد مشخص و یک حوزه
یک مسئله انتخاب کنید که هم دردناک است و هم قابل اندازهگیری؛ مثلاً «گزارش فروش و سود هر ماه دو هفته دیر میرسد» یا «نمیدانیم بهای واقعی محصولاتمان با نرخ ارز امروز چقدر است». منابع دادهٔ همان حوزه را به انبار داده وصل کنید.
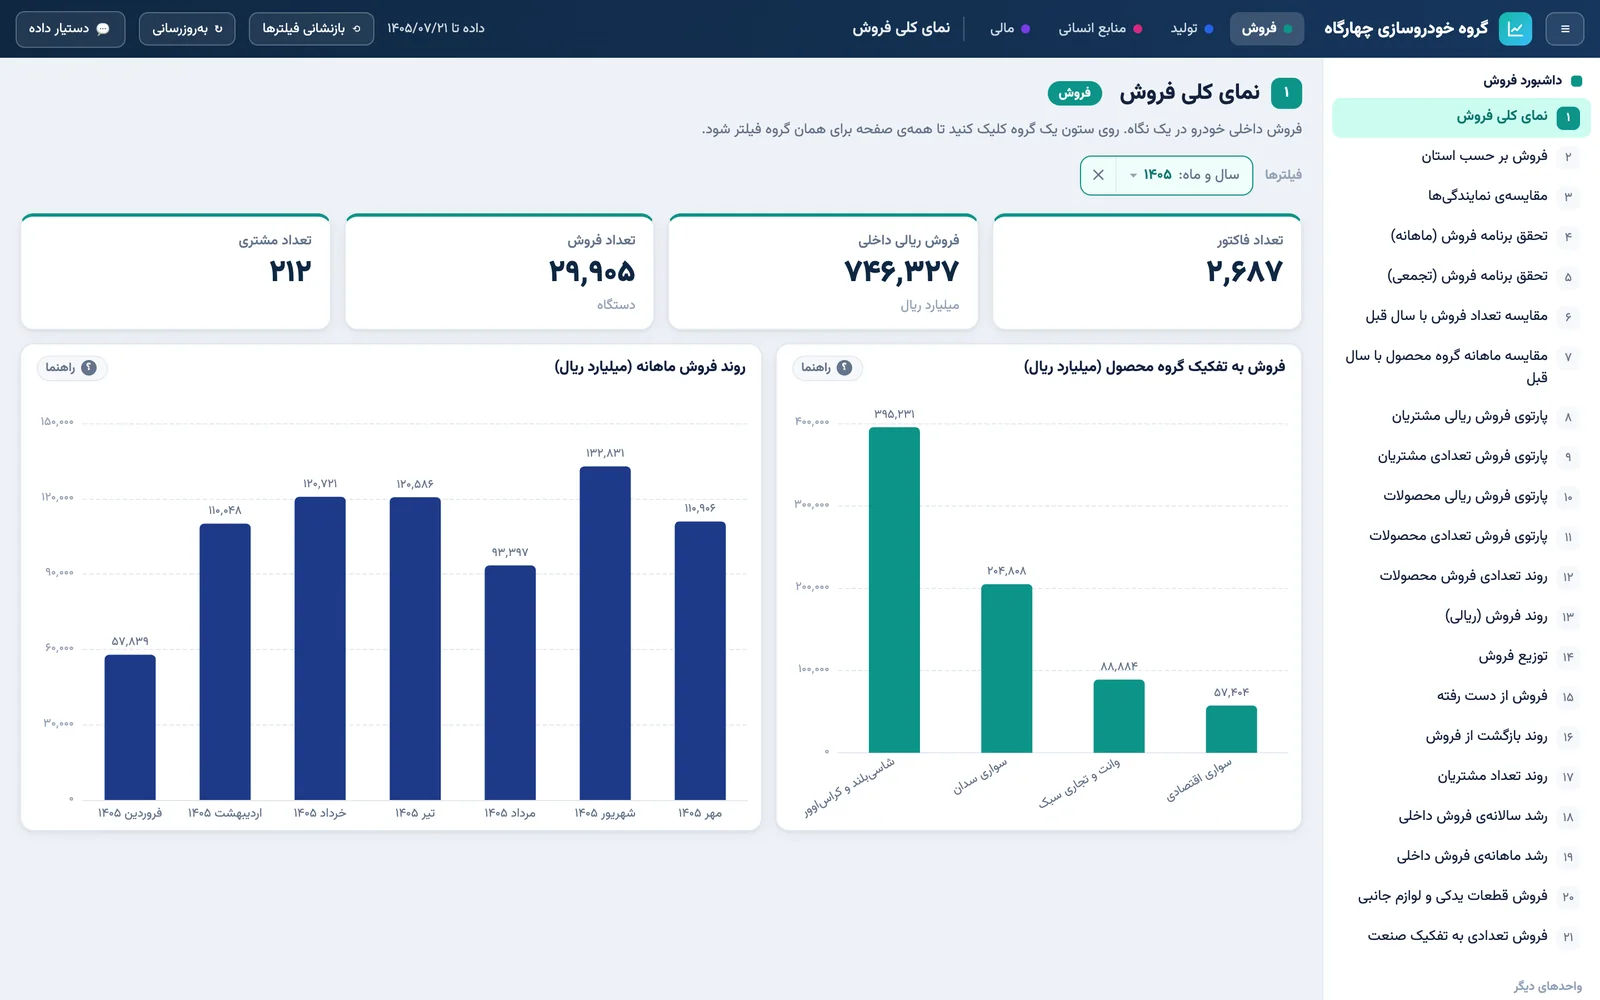
مرحلهٔ دوم: داشبوردی که مدیر واقعاً نگاهش کند
برای همان حوزه داشبوردی بسازید که با یک نگاه بگوید کجا مشکل است. داشبورد خوب کمحرف است: چند شاخص کلیدی، روند و امکان رفتن به جزئیات.
مرحلهٔ سوم: دستیار هوشمند و پیشبینی
وقتی داده یکپارچه و داشبورد جاافتاده شد، نوبت لایهٔ هوش مصنوعی است: دستیاری که به سؤالهای غیرتکراری جواب بدهد، مدل پیشبینی فروش یا تقاضا و هشدارهایی که پیش از بحران خبر بدهند.
نکتهٔ عملی
اولین خروجیها باید حداکثر ۲ تا ۳ ماه پس از شروع دیده شوند: انبار دادهٔ حوزهٔ اول و نسخهٔ اولیهٔ داشبوردها. اگر پروژهای تا شش ماه هیچ چیز قابل استفادهای تحویل نمیدهد، احتمالاً خیلی بزرگ تعریف شده است.
پنج اشتباه رایج در پروژههای هوش مصنوعی سازمانی
- شروع از مدل، بهجای داده. خرید یا ساخت مدل پیشرفته روی دادهای که پاک و یکپارچه نیست، فقط خطا را سریعتر میکند.
- نداشتن تعریف مشترک. اگر «فروش» برای واحد فروش و واحد مالی دو عدد متفاوت است، اول باید تعریف را یکی کرد.
- داشبورد بیش از حد. صد نمودار یعنی هیچ تصمیمی. هر صفحه باید به یک سؤال جواب بدهد.
- نادیده گرفتن اکسلها. بخش بزرگی از دانش عملیاتی سازمان در اکسلهاست. باید آنها را به انبار داده وصل کرد، نه اینکه نادیدهشان گرفت.
- بیتوجهی به امنیت از روز اول. سطح دسترسی و محرمانگی داده را باید از ابتدا طراحی کرد، نه بعد از اولین نشت.
امنیت و محرمانگی داده
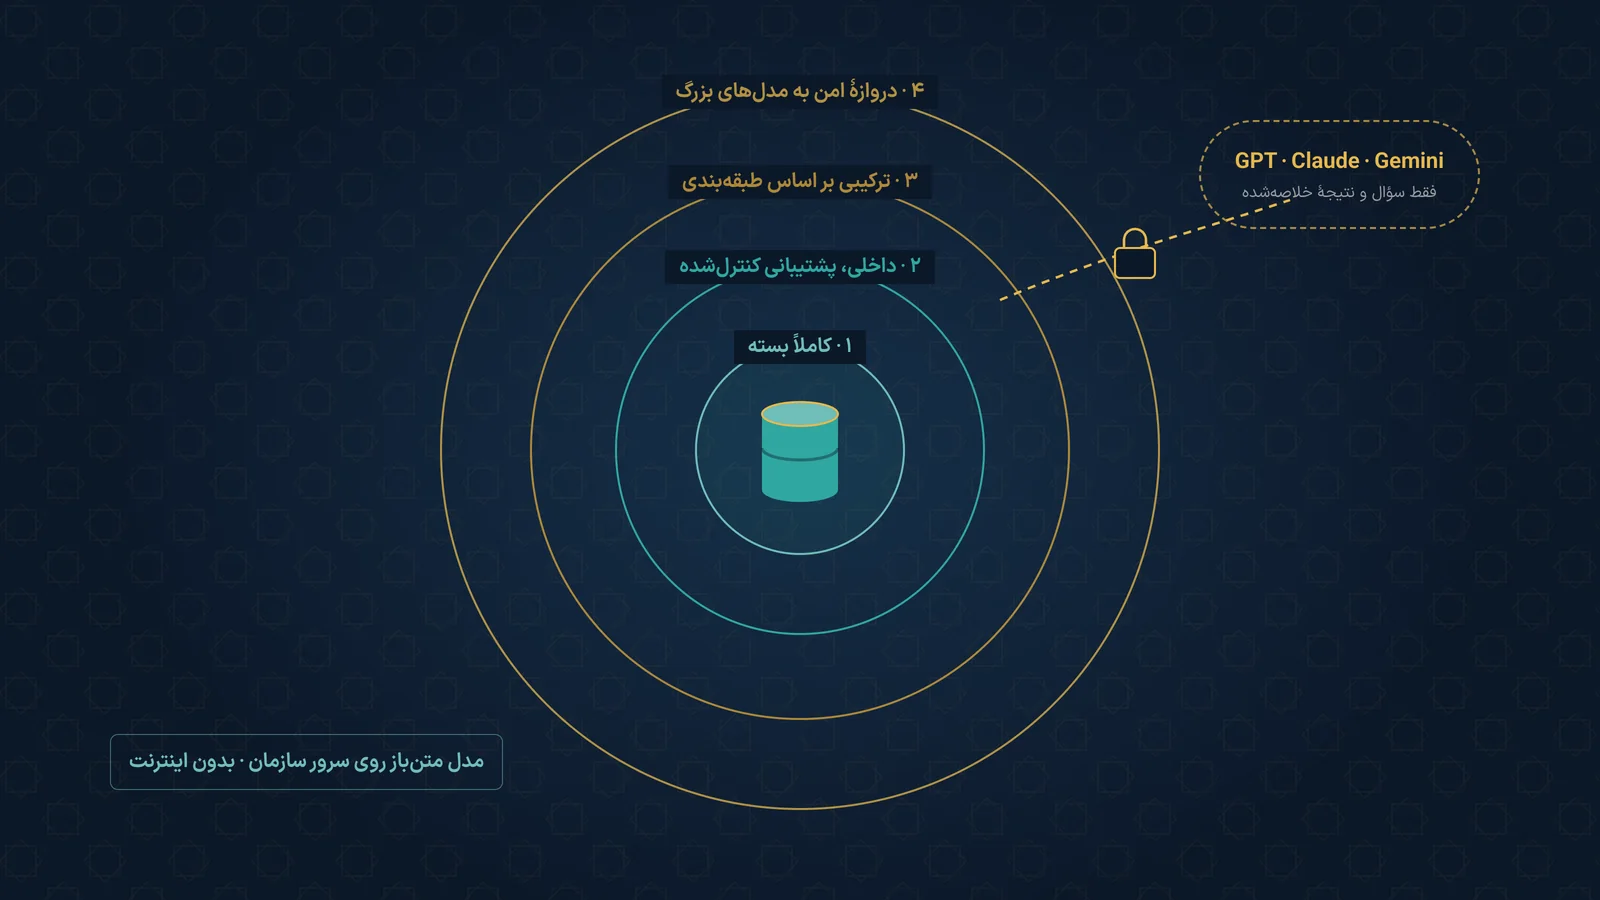
نگرانی اول بیشتر مدیران این است: «دادهٔ ما کجا میرود؟» پاسخ درست، معماری درست است:
- دسترسی فقطخواندنی: هوش مصنوعی در انبار داده چیزی نمینویسد و تغییری نمیدهد.
- سطح دسترسی: هر کاربر فقط دادهٔ حوزهٔ خودش را میبیند؛ پرسیدن از هوش مصنوعی راه دور زدن دسترسی نیست.
- محل نگهداری داده: داده میتواند روی سرور خود سازمان بماند و در صورت نیاز از مدل زبانی محلی استفاده شود.
- شفافیت: هر پاسخ همراه پرسوجویی است که از آن ساخته شده، تا هر عدد قابل پیگیری باشد.
جمعبندی
هوش مصنوعی سازمانی جادو نیست؛ زنجیرهای است از دادهٔ پاک، تعریف مشترک، داشبورد کمحرف و در نهایت دستیاری که توضیح میدهد. سازمانی که ERP و چند سال سابقهٔ داده دارد، معمولاً آمادهتر از آن است که فکر میکند.
پرسشهای پرتکرار
هوش مصنوعی سازمانی با ChatGPT چه فرقی دارد؟
ChatGPT از دانش عمومی جواب میدهد و دادهٔ فروش، تولید یا مالی سازمان شما را نمیشناسد. هوش مصنوعی سازمانی به دادههای خود سازمان وصل است، با سطح دسترسی هر کاربر کار میکند و پاسخش را از عددهای واقعی سازمان میسازد.
آیا برای شروع هوش مصنوعی حتماً انبار داده لازم است؟
برای یک آزمایش کوچک نه، ولی برای استفادهٔ روزمره و قابل اتکا بله. وقتی داده در چند سیستم و دهها اکسل پخش است، هوش مصنوعی هم همان تناقضها را تکرار میکند. انبار داده یک منبع واحد و پاک برای همه میسازد.
اجرای هوش مصنوعی سازمانی چقدر طول میکشد؟
اولین خروجیها حداکثر ۲ تا ۳ ماه پس از شروع دیده میشوند. معمولاً انبار داده حدود پایان ماه دوم و نسخهٔ اولیهٔ داشبوردها حدود پایان ماه سوم آماده است. زمان دقیق به تعداد منابع داده و کیفیت آنها بستگی دارد. بهتر است با یک حوزه (مثلاً فروش یا تولید) شروع کنید و بعد حوزههای دیگر را اضافه کنید.
آیا دادهٔ سازمان از کشور یا از سرور ما خارج میشود؟
لازم نیست. معماری را میشود طوری چید که داده روی سرور خود سازمان بماند، دسترسی هوش مصنوعی فقطخواندنی باشد و از مدل زبانی محلی استفاده شود. گزینههای مختلف، از کاملاً بسته تا متصل به مدلهای بزرگ، را در مقالهٔ امنیت داده در هوش مصنوعی سازمانی توضیح دادهایم.