چرا چت با ChatGPT، Gemini یا Claude شخصی جای دستیار هوشمند سازمانی را نمیگیرد
بارگذاری چند اکسل در ChatGPT، Gemini یا Claude برای تحلیل دادهٔ سازمان وسوسهانگیز است، ولی دید ناقص، عددهای نادرست و ریسک محرمانگی دارد. چرا راه درست، وصل کردن مدلهای زبانی بزرگ یا متنباز به انبار داده است.

فهرست مطالب
بسیاری از مدیران پیشرو امروز از هوش مصنوعی استفاده میکنند: چند فایل اکسل از واحدها میگیرند، در ChatGPT، Gemini یا Claude بارگذاری میکنند و از آن تحلیل میخواهند. این نشانهٔ نگاه درست به آینده است. ولی مشکل در مدل زبانی نیست؛ در دادهای است که به آن داده میشود. مدل فقط به اندازهٔ همان چند فایل میداند و پاسخش، هرقدر هم مطمئن به نظر برسد، از آن دقیقتر نمیشود.
چه اتفاقی میافتد وقتی اکسل را به چتبات عمومی میدهید؟
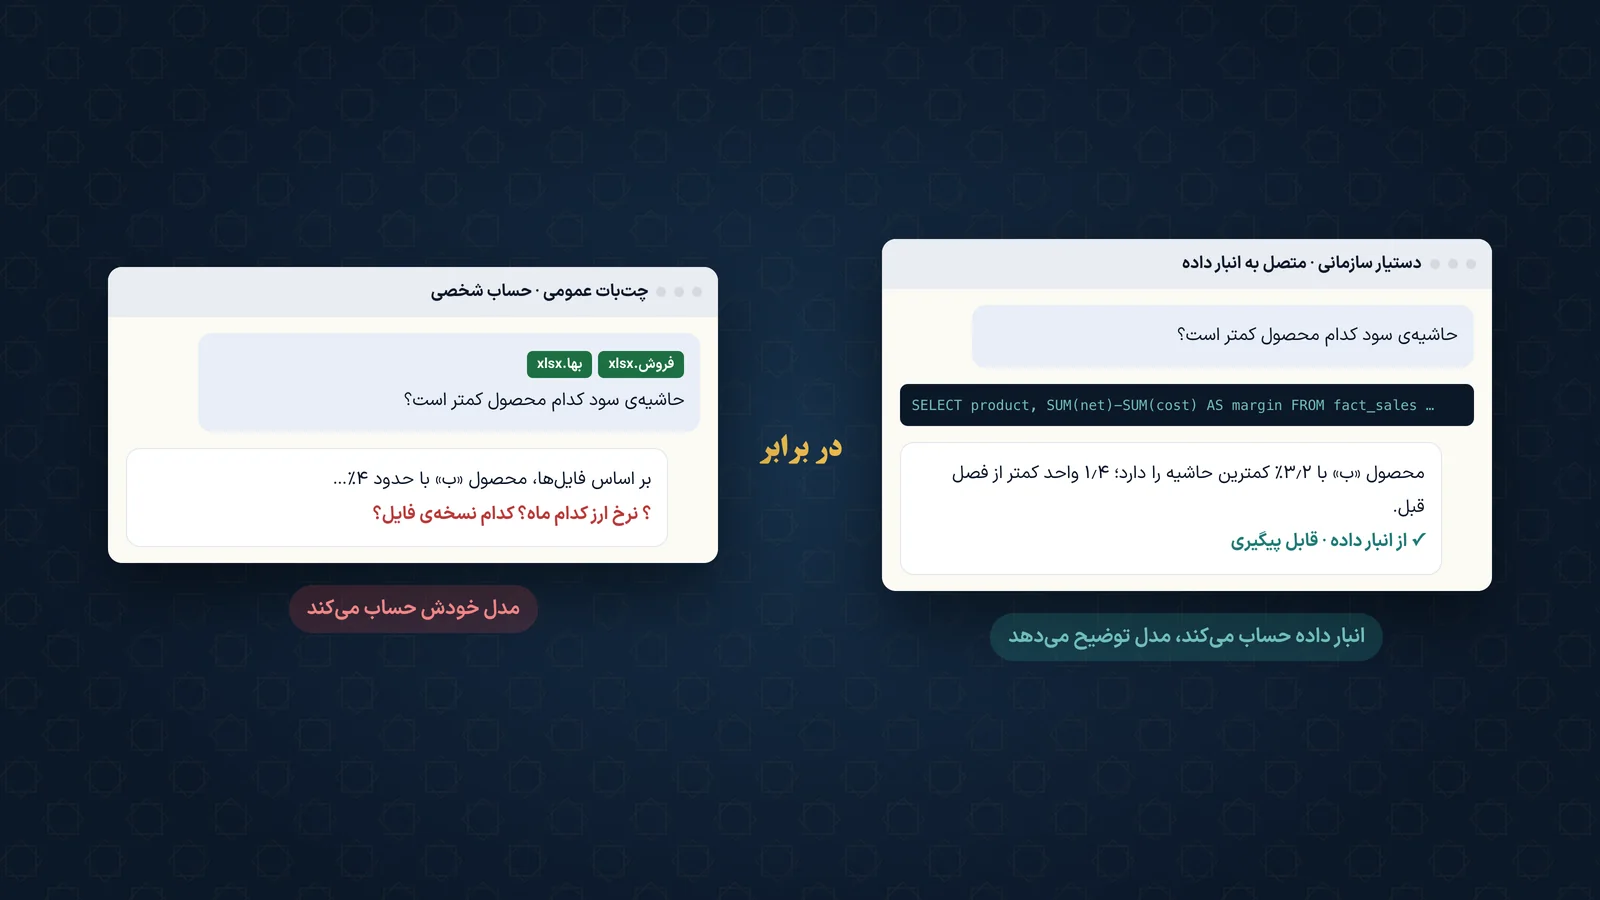
فرض کنید مدیر مالی سه فایل فروش، بهای تمامشده و برگشتی سه ماه اخیر را در چتبات بارگذاری میکند و میپرسد «حاشیهٔ سود کدام محصول از همه کمتر است؟». مدل پاسخی تمیز و مطمئن میدهد. اما پشت این پاسخ چند فرض پنهان هست:
- مدل نمیداند فایل بهای تمامشده با نرخ ارز کدام ماه حساب شده است.
- نمیداند یک ستون «مبلغ» قبل از تخفیف است یا بعد از آن.
- اگر فایل بزرگ باشد، ممکن است فقط بخشی از آن را خوانده باشد.
- جمع و تقسیم را خودش انجام داده و روی جدولهای بزرگ ممکن است اشتباه کند، بیآنکه هشداری بدهد.
نتیجه عددی است که در جلسه مطرح میشود، ولی کسی نمیتواند بگوید از کجا آمده است.
هفت تفاوت اصلی
| بارگذاری اکسل در چتبات عمومی | دستیار هوشمند متصل به انبار داده | |
|---|---|---|
| دید مدل | فقط همان چند فایل؛ نمیداند چه چیزی را ندیده است | کل دادهٔ سازمان، از ERP تا اکسلهای کنار آن |
| تازگی داده | عکسی از لحظهٔ خروجی گرفتن؛ هر بار باید از نو آماده شود | بهروز و خودکار |
| دقت عددها | مدل خودش حساب میکند و ممکن است با اطمینان عدد غلط بدهد | عدد با پرسوجوی مستقیم از انبار داده حساب میشود و قابل پیگیری است |
| حجم داده | محدود به ظرفیت ورودی چتبات | چند سال تاریخچه، بدون محدودیت عملی |
| معنای داده | مدل حدس میزند هر ستون و کد چه معنایی دارد | تعریف هر شاخص و کد در انبار داده ثبت شده است |
| محرمانگی | اطلاعات فروش، مشتری و بهای تمامشده در حساب شخصی و روی سرور بیرونی میماند | روی سرور سازمان یا میزبانی امن، با سطح دسترسی |
| استفادهٔ سازمانی | یک نفر، یک گفتگو؛ نتیجه تکرارپذیر نیست | همهٔ مدیران با یک منبع و یک تعریف |
مدل زبانی فکر میکند، انبار داده عدد درست میدهد
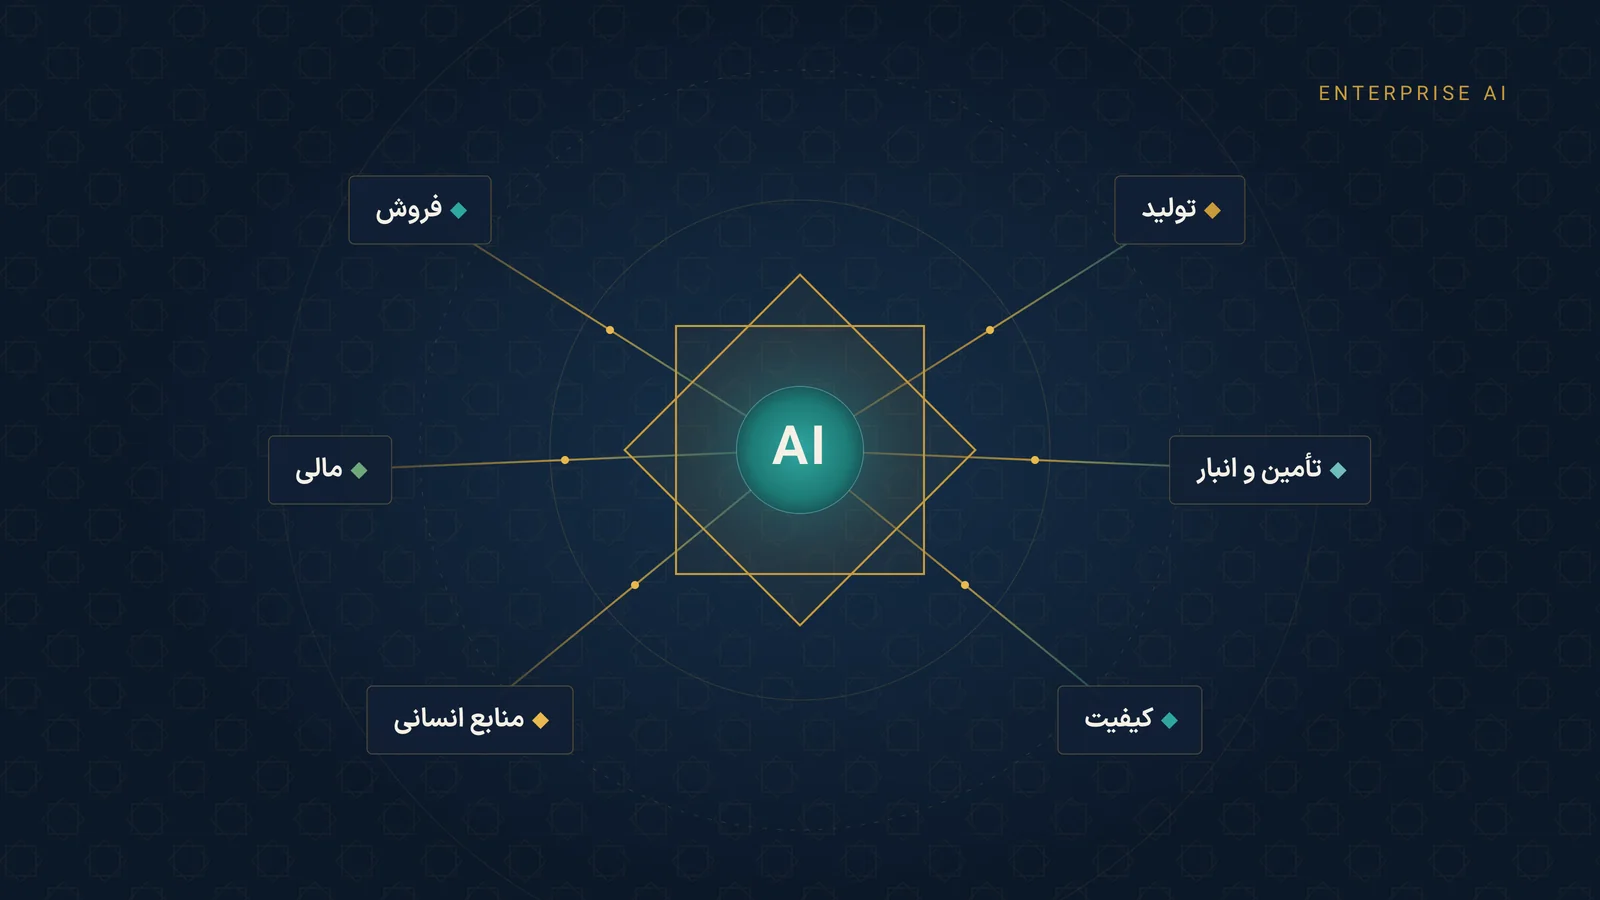
راهحل کنار گذاشتن مدلهای زبانی نیست؛ این مدلها در فهم سؤال، نوشتن پرسوجو و توضیح نتیجه فوقالعادهاند. راهحل این است که هر کس کار خودش را بکند:
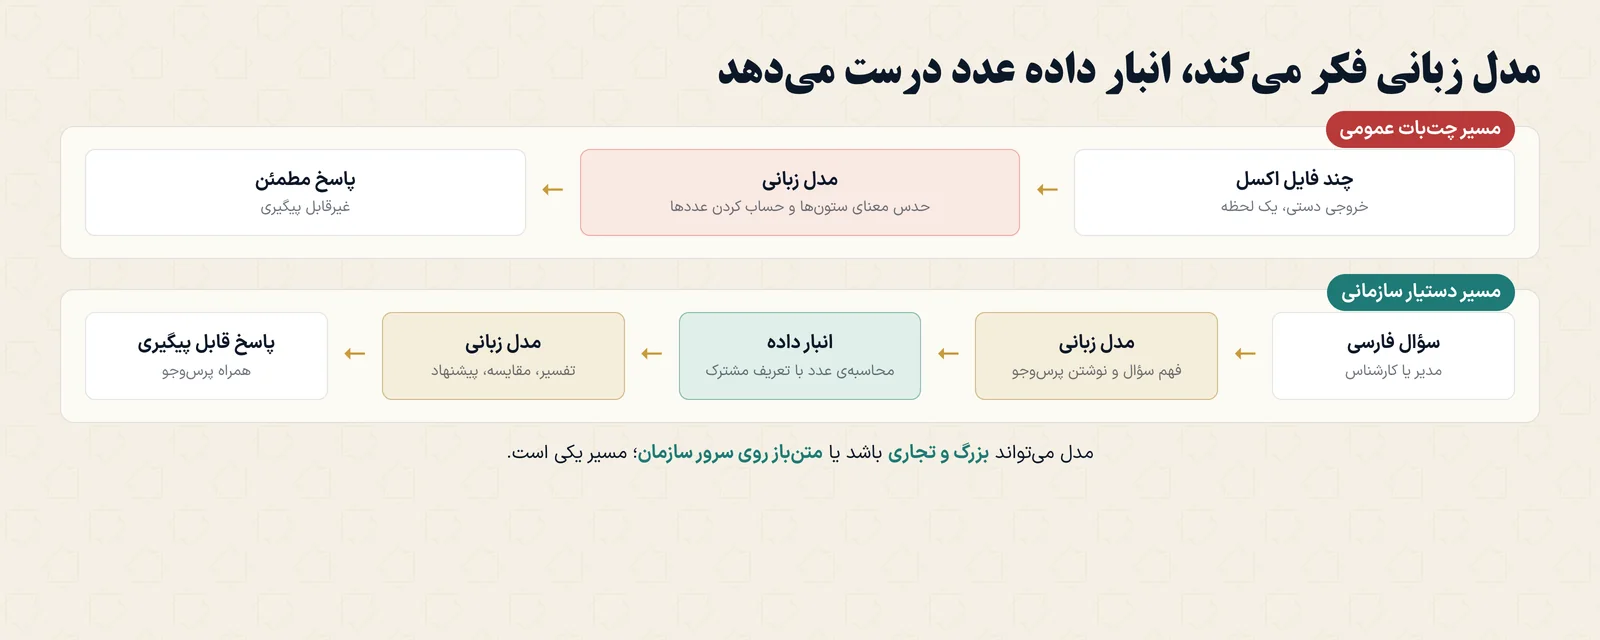
- مدل زبانی سؤال فارسی مدیر را میفهمد و تشخیص میدهد کدام شاخص، کدام دوره و کدام مقایسه منظور است.
- مدل پرسوجو را مینویسد و آن را روی انبار داده اجرا میکند؛ با دسترسی فقطخواندنی.
- انبار داده عدد را حساب میکند؛ با همان تعریفی که داشبوردها و گزارش هیئتمدیره دارند.
- مدل نتیجه را تفسیر میکند: مقایسه با دورهٔ قبل، پیدا کردن علت و پیشنهاد.
به این ترتیب سازمان قدرت ChatGPT و Claude را دارد، ولی روی دادهٔ کامل، تمیز و بهروز خودش و با پاسخی که میشود رویش تصمیم گرفت.
مدل بزرگ تجاری یا مدل متنباز؟
وقتی داده در انبار داده آماده باشد، انتخاب مدل زبانی یک تصمیم مستقل است و میشود آن را بعداً عوض کرد:
- مدلهای بزرگ تجاری (مثل خانوادهٔ GPT، Claude یا Gemini): بیشترین توان استدلال را دارند. اتصالشان از یک دروازهٔ کنترلشده است و فقط سؤال و نتیجهٔ خلاصهشده به آنها میرسد.
- مدلهای متنباز روی سرور سازمان: داده هیچوقت از سازمان خارج نمیشود. برای پرسشهای تحلیلی روزمره و فارسی، توان کافی دارند.
- ترکیبی: دادهٔ محرمانه فقط به مدل محلی میرود و کارهای کمحساس به مدلهای قویتر سپرده میشوند.
جزئیات این گزینهها و کنترلهای امنیتی هر کدام را در مقالهٔ امنیت داده در هوش مصنوعی سازمانی نوشتهایم.
نمونهٔ واقعی
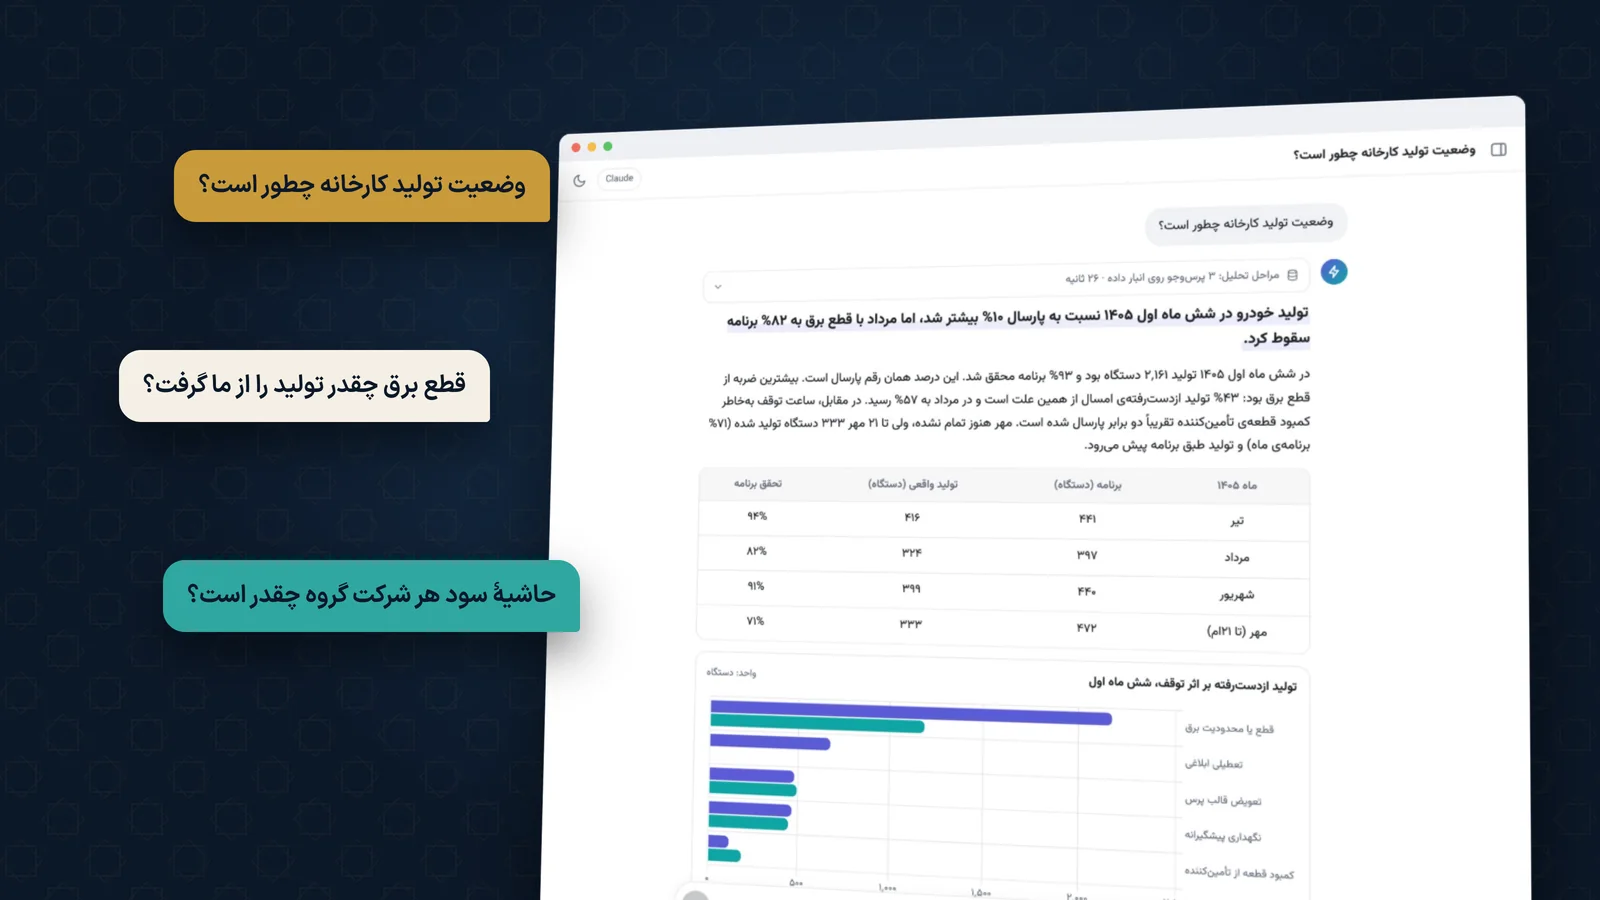
در مقالهٔ دستیار هوشمند سازمانی میتوانید پاسخهای واقعی دستیار را روی انبار دادهٔ دمو ببینید. هر پاسخ همراه «مراحل تحلیل» و پرسوجویی است که از آن ساخته شده است.
پس با ChatGPT شخصی چه کنیم؟
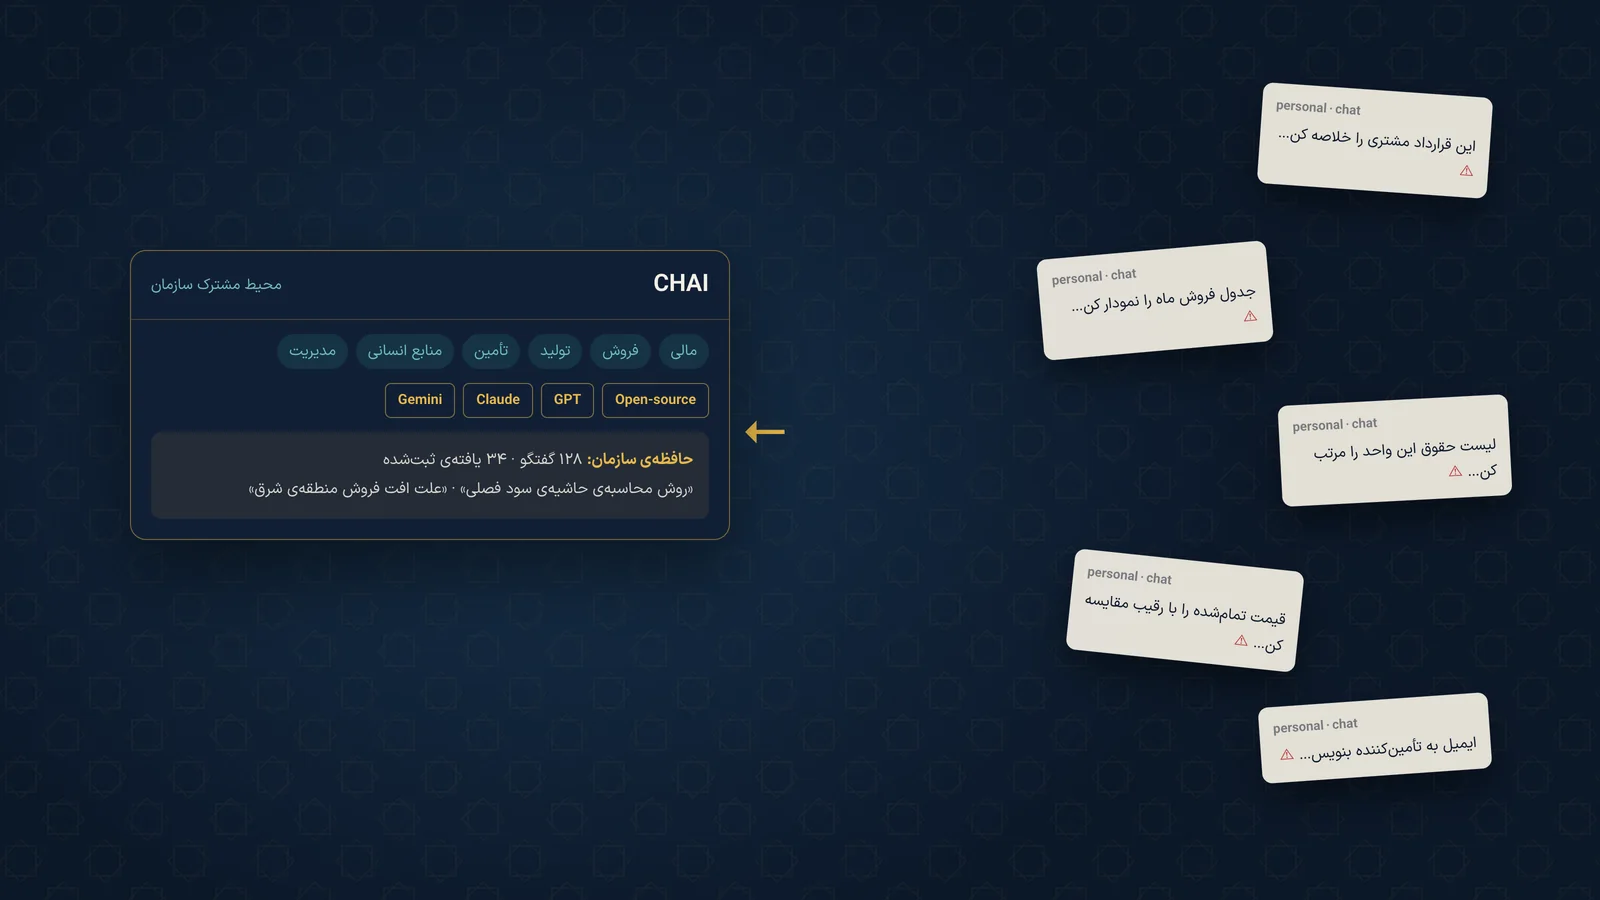
کنار گذاشتنش نه ممکن است و نه لازم. ولی وقتی همکاران هر روز دادهٔ سازمان را در حسابهای شخصی خود بارگذاری میکنند، دانش و داده هر دو از دست سازمان خارج میشوند. راه بهتر یک محیط مشترک است که همه با حساب سازمانی وارد آن شوند و مدل دلخواهشان را انتخاب کنند، و گفتگوها و یافتهها در خود سازمان بماند. این همان کاری است که CHAI انجام میدهد. دربارهٔ آن در مقالهٔ هوش مصنوعی پنهان در سازمان مفصل نوشتهایم.
پرسشهای پرتکرار
آیا ChatGPT یا Claude برای تحلیل اکسلهای سازمان بد است؟
برای تحلیل شخصی و یکباره ابزار خوبی است. ولی برای تصمیمهای سازمانی سه مشکل دارد. فقط فایلهایی را میبیند که به آن دادهاید. روی جدولهای بزرگ ممکن است در حساب کردن اشتباه کند. دادهٔ محرمانه هم روی سرور بیرونی و در حساب شخصی افراد میماند.
دستیار سازمانی از کدام مدل زبانی استفاده میکند؟
بسته به انتخاب سازمان، از مدلهای بزرگ تجاری یا مدلهای متنباز روی سرور خود سازمان. چون همهٔ درخواستها از یک دروازه عبور میکنند، مدل را میشود بدون تغییر سامانه عوض کرد.
اگر مدل زبانی عدد را حساب نمیکند، پس دقیقاً چه کار میکند؟
سؤال فارسی را میفهمد، تشخیص میدهد کدام شاخص و کدام دوره مدنظر است، پرسوجوی لازم را روی انبار داده مینویسد و نتیجه را توضیح میدهد، مقایسه میکند و پیشنهاد میدهد. محاسبهٔ عدد با خود پایگاه داده است.