امنیت داده در هوش مصنوعی سازمانی؛ از معماری کاملاً بسته تا اتصال به مدلهای بزرگ
دادهٔ سازمان در پروژهٔ هوش مصنوعی کجا میرود؟ چهار معماری رایج، از کاملاً بسته و بدون اینترنت با مدلهای متنباز تا اتصال کنترلشده به مدلهای بزرگ، و کنترلهای امنیتی که در همهٔ آنها ثابت است.

فهرست مطالب
اولین سؤال تقریباً هر مدیرعاملی در جلسهٔ هوش مصنوعی این است: «دادهٔ ما کجا میرود؟» پاسخ کوتاه این است که به انتخاب خود سازمان بستگی دارد. هوش مصنوعی سازمانی را میشود کاملاً بسته، روی سرور داخلی و بدون هیچ اتصالی به اینترنت اجرا کرد. میشود هم آن را بهصورت کنترلشده به قویترین مدلهای زبانی دنیا وصل کرد. بین این دو هم چند حالت میانی هست.
این مقاله چهار معماری رایج را مقایسه میکند و کنترلهایی را توضیح میدهد که در همهٔ آنها ثابتاند.
اول: دادهی شما دقیقاً کجاست؟
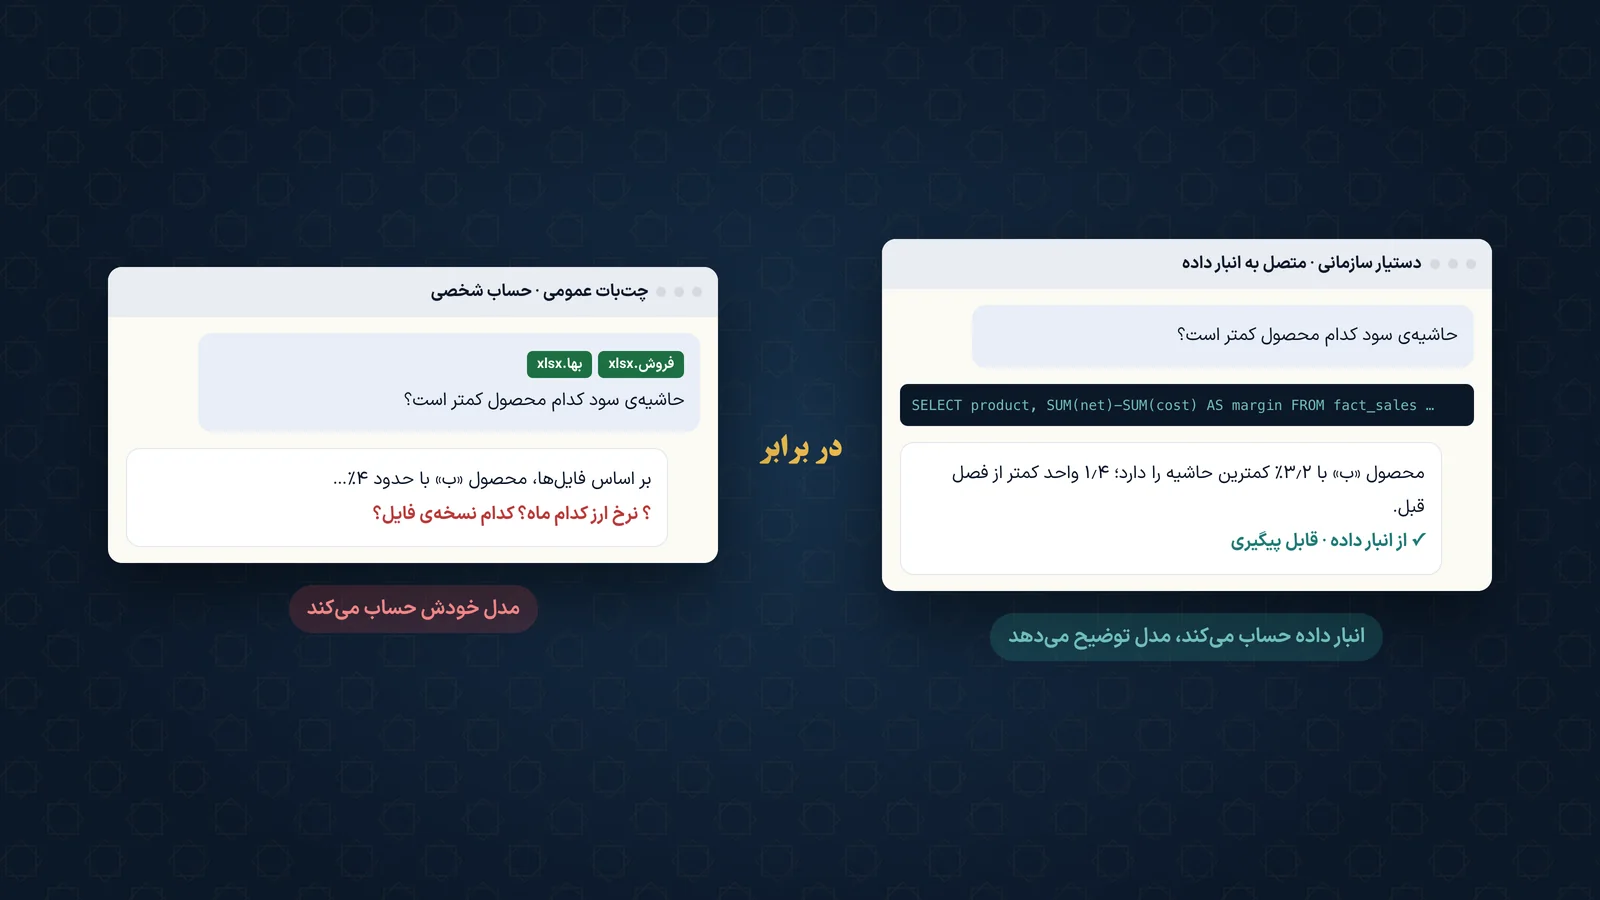
پیش از انتخاب معماری، باید یک تصور رایج را اصلاح کرد. در دستیار هوشمند سازمانی، مدل زبانی جای داده نیست. داده در انبار داده میماند و عددها با پرسوجوی مستقیم روی همان انبار حساب میشوند. مدل زبانی سؤال را میفهمد، پرسوجو را مینویسد و نتیجه را توضیح میدهد.
پس سؤال امنیتی اصلی این نیست که «انبار داده کجا نصب شود». سؤال این است: مدل زبانی کجا اجرا شود و چه چیزی به آن برسد؟
چهار معماری، از کاملاً بسته تا متصل
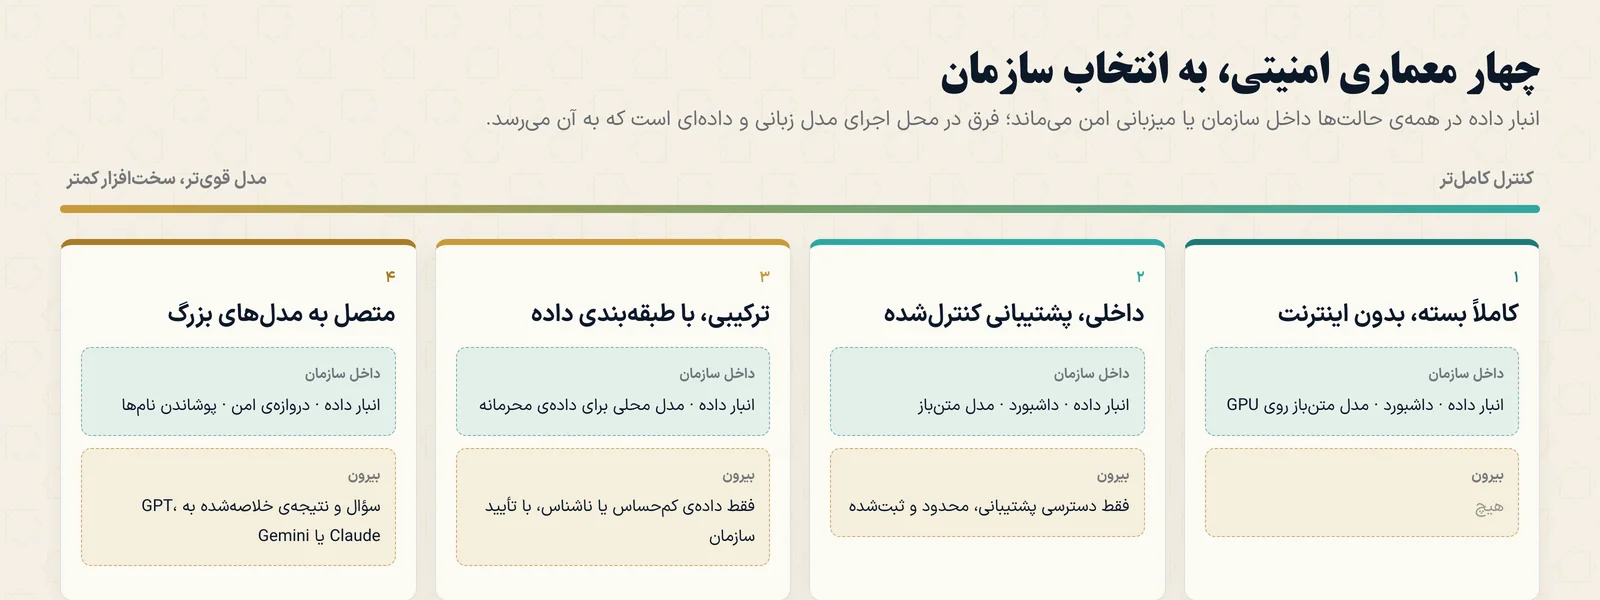
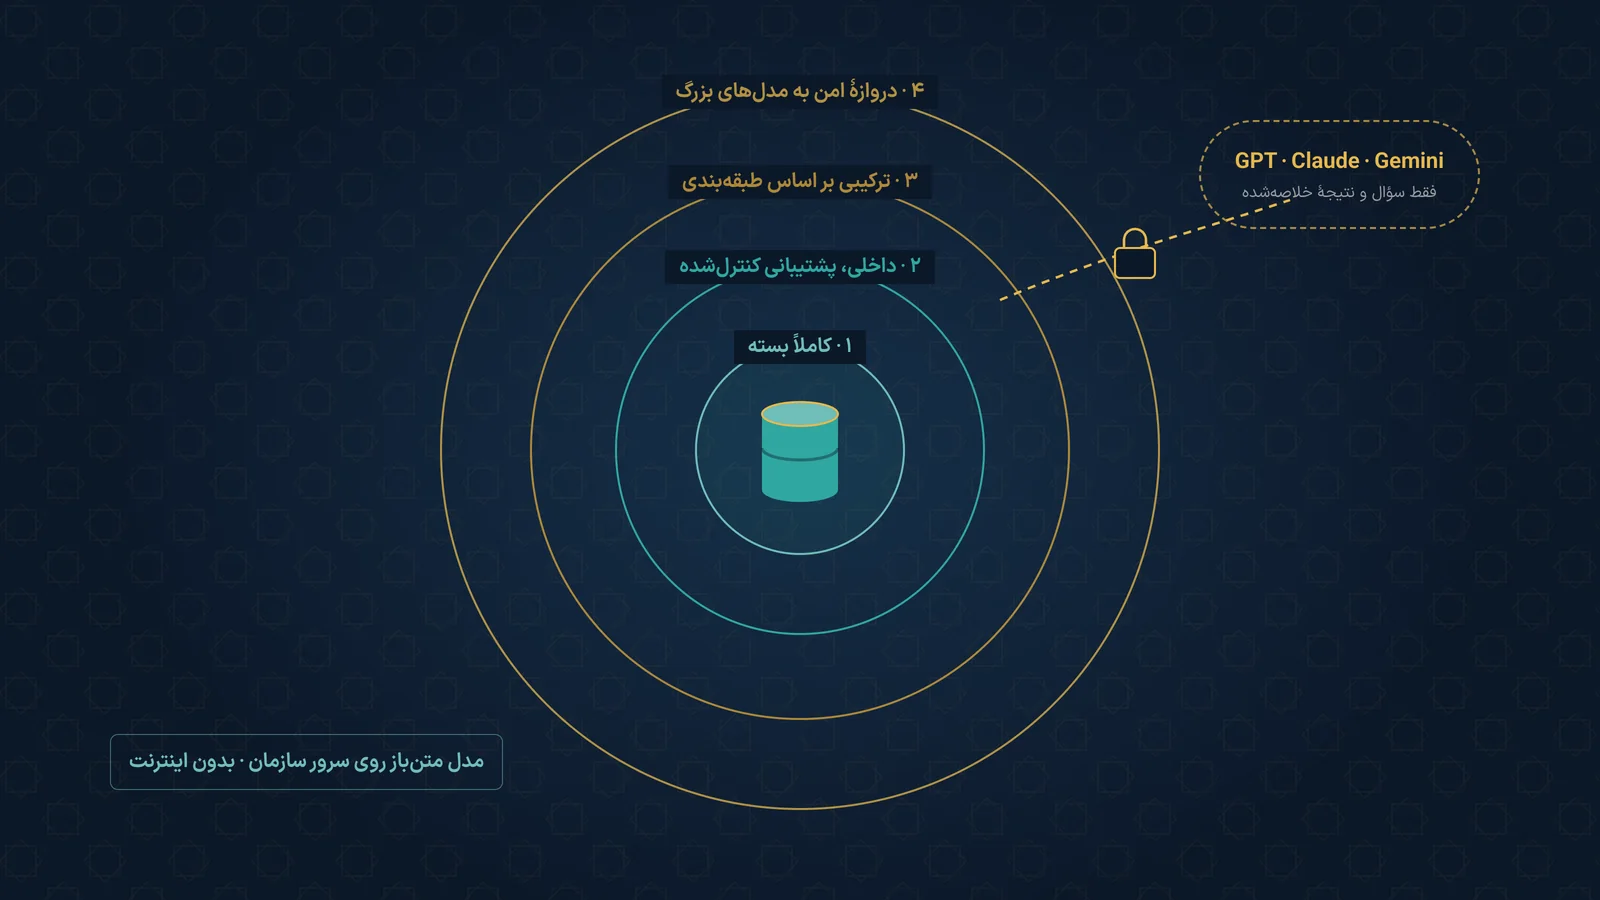
۱. کاملاً بسته و بدون اینترنت
انبار داده، داشبوردها و یک مدل زبانی متنباز همه روی سرورهای خود سازمان نصب میشوند. سرور هیچ ارتباطی با اینترنت ندارد و بهروزرسانیها با فرایند کنترلشدهٔ خود سازمان وارد میشوند.
- برای چه سازمانی: دادههای بسیار حساس، صنایع دارای الزامات سختگیرانه یا سازمانهایی که سیاست قطعی «هیچ دادهای بیرون نرود» دارند.
- پیشنیاز: سرور با پردازندهٔ گرافیکی (GPU) مناسب برای اجرای مدل.
- محدودیت: مدلهای متنباز در سؤالهای تحلیلی روزمره خوباند، ولی در استدلالهای خیلی پیچیده به پای بزرگترین مدلهای تجاری نمیرسند.
۲. داخل سازمان، با پشتیبانی کنترلشده
مثل حالت اول، همه چیز روی سرور سازمان است و مدل محلی اجرا میشود. تفاوتش این است که تیم پشتیبانی از راه دور و با دسترسی محدود، زماندار و ثبتشده به سرور وصل میشود تا نگهداری و بهروزرسانی سادهتر شود.
- برای چه سازمانی: بیشتر سازمانهایی که داده را حساس میدانند ولی تیم فنی داخلی بزرگی برای نگهداری ندارند.
۳. ترکیبی، بر اساس طبقهبندی داده
دادهها طبقهبندی میشوند. دادهٔ محرمانه (نام افراد، مشتریان، حقوق، قیمتها) فقط به مدل محلی میرسد. دادهٔ کمحساس یا ناشناسشده (مثلاً متن بدون نام یا عددهای تجمیعی) میتواند برای مدلهای قویتر بیرونی فرستاده شود، آن هم فقط با تأیید کتبی سازمان.
- برای چه سازمانی: سازمانی که هم امنیت میخواهد و هم در بعضی کارها، مثل خلاصهنویسی یا تحلیل متن، به قدرت مدلهای بزرگ نیاز دارد.
- نکتهٔ کلیدی: قاعدهٔ طبقهبندی در سامانه نوشته میشود و به تصمیم لحظهای کاربر وابسته نیست. سامانه دادهٔ محرمانه را اصلاً به مسیر بیرونی نمیفرستد.
۴. متصل به مدلهای بزرگ، از دروازهٔ امن
دستیار هوشمند به مدلهای بزرگ تجاری مثل GPT، Claude یا Gemini وصل میشود؛ مستقیم یا از طریق سرویسهای واسط داخلی. اتصال هم از یک دروازهٔ کنترلشده میگذرد. حتی در این حالت:
- انبار داده داخل سازمان یا روی میزبانی امن میماند و کل آن هرگز به بیرون نمیرود.
- به مدل فقط سؤال کاربر و نتیجهٔ خلاصهشدهٔ پرسوجو میرسد، نه جدولهای خام.
- اطلاعات شناسایی مثل نام افراد و مشتریان پیش از ارسال حذف یا پوشانده میشوند.
-
شرایط سرویسدهنده دربارهٔ نگهداری داده و استفاده از آن برای آموزش مدل، پیش از اتصال بررسی میشود.
-
برای چه سازمانی: سازمانی که بیشترین توان تحلیلی را میخواهد و دادههایش در سطح خلاصهشده حساسیت بالایی ندارد.
مقایسهی چهار معماری
| کاملاً بسته | داخلی، پشتیبانی کنترلشده | ترکیبی | متصل به مدلهای بزرگ | |
|---|---|---|---|---|
| اتصال به اینترنت | ندارد | فقط برای پشتیبانی، محدود و ثبتشده | فقط برای دادهٔ مجاز | از دروازهٔ امن |
| محل اجرای مدل | سرور سازمان | سرور سازمان | محلی و بیرونی | بیرونی |
| دادهٔ خروجی | هیچ | هیچ | فقط دادهٔ کمحساس یا ناشناس | سؤال و نتیجهٔ خلاصهشده |
| توان تحلیلی مدل | خوب | خوب | خوب تا عالی | عالی |
| هزینهٔ سختافزار | بیشتر (GPU) | بیشتر (GPU) | متوسط | کمتر |
کنترلهایی که در هر چهار معماری ثابتاند
هر معماریای که انتخاب کنید، این کنترلها همیشه برقرارند:
- دسترسی فقطخواندنی: هوش مصنوعی در انبار داده چیزی نمینویسد، پاک نمیکند و تغییر نمیدهد. به ERP و سیستمهای عملیاتی هم مستقیم وصل نیست.
- سطح دسترسی کاربر: دستیار همان دسترسی کاربر را دارد. مدیر فروش با پرسیدن از دستیار به دادههای حقوق نمیرسد.
- طبقهبندی داده: حساسیت هر داده مشخص است و سامانه مسیر مجاز هر طبقه را خودش اعمال میکند.
- ثبت همه چیز: هر سؤال، هر پرسوجو و هر پاسخ با نام کاربر و زمان ثبت میشود و قابل ممیزی است.
- شفافیت پاسخ: هر عدد همراه پرسوجویی نشان داده میشود که از آن ساخته شده است.
- یک دروازهٔ واحد: همهٔ درخواستها به مدلها از یک دروازه میگذرند. پس عوض کردن مدل یا معماری بعداً ساده است و به بازنویسی سامانه نیاز ندارد.
از کجا شروع کنیم؟
بسیاری از سازمانها با معماری داخلی شروع میکنند و پس از چند ماه، وقتی طبقهبندی دادهها روشن شد، برای بعضی کارها معماری ترکیبی را فعال میکنند. این تصمیم برگشتپذیر است و لازم نیست از روز اول برای همیشه گرفته شود.
امنیت، دلیلی برای کنار گذاشتن هوش مصنوعی نیست
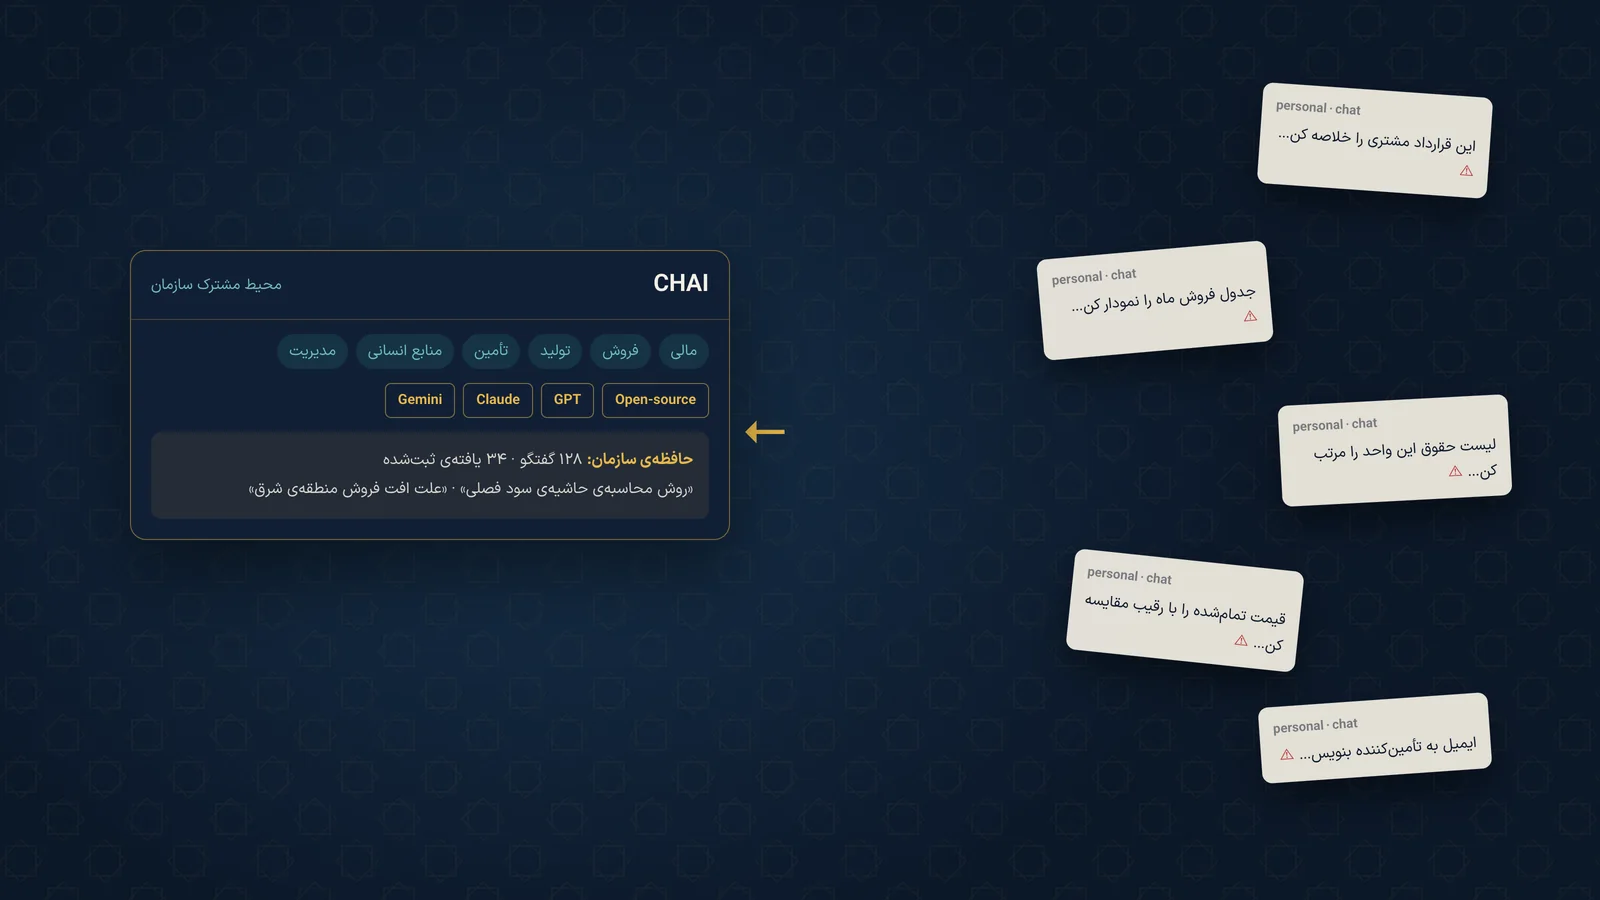
شاید بزرگترین ریسک امنیتی امروز در سازمانها، خود هوش مصنوعی سازمانی نباشد. ریسک بزرگتر، همکارانیاند که هر روز گزارش فروش و قرارداد مشتری را در حساب شخصی ChatGPT کپی میکنند. در مقالهٔ هوش مصنوعی پنهان در سازمان دربارهٔ این ریسک و راهحلش نوشتهایم. برای مقایسهٔ چتباتهای عمومی با دستیار متصل به انبار داده هم این مقاله را بخوانید.
پرسشهای پرتکرار
آیا میشود هوش مصنوعی را کاملاً بدون اینترنت اجرا کرد؟
بله. انبار داده و یک مدل زبانی متنباز روی سرور خود سازمان نصب میشوند و هیچ ارتباطی با بیرون ندارند. برای کار روان، سرور به پردازندهٔ گرافیکی (GPU) مناسب نیاز دارد. مدلهای متنباز امروز فارسی را خوب میفهمند و برای پرسش از داده کافیاند.
اگر به مدلهای بزرگ مثل GPT یا Claude وصل شویم، کل دادههای ما برای آنها فرستاده میشود؟
نه. عددها با پرسوجو روی انبار داده داخل سازمان حساب میشوند. به مدل فقط سؤال و نتیجهٔ خلاصهشده میرسد، و دادههای حساس مثل نام افراد یا مشتریان پیش از ارسال حذف یا پوشانده میشوند. کدام داده اجازهٔ خروج دارد، با طبقهبندیای تعیین میشود که خود سازمان تأیید میکند.
کدام معماری را انتخاب کنیم؟
به حساسیت داده، الزامات قانونی صنعت و زیرساخت موجود بستگی دارد. بسیاری از سازمانها با معماری داخلی یا ترکیبی شروع میکنند. چون همهٔ درخواستها از یک دروازه عبور میکنند، عوض کردن معماری بعداً بدون بازنویسی سامانه ممکن است.
آیا هوش مصنوعی میتواند دادهها را تغییر دهد یا پاک کند؟
نه. دسترسی دستیار هوشمند به انبار داده فقطخواندنی است و به سیستمهای عملیاتی مثل ERP هم مستقیم وصل نمیشود.